定位:题目来自真实的缺陷修复
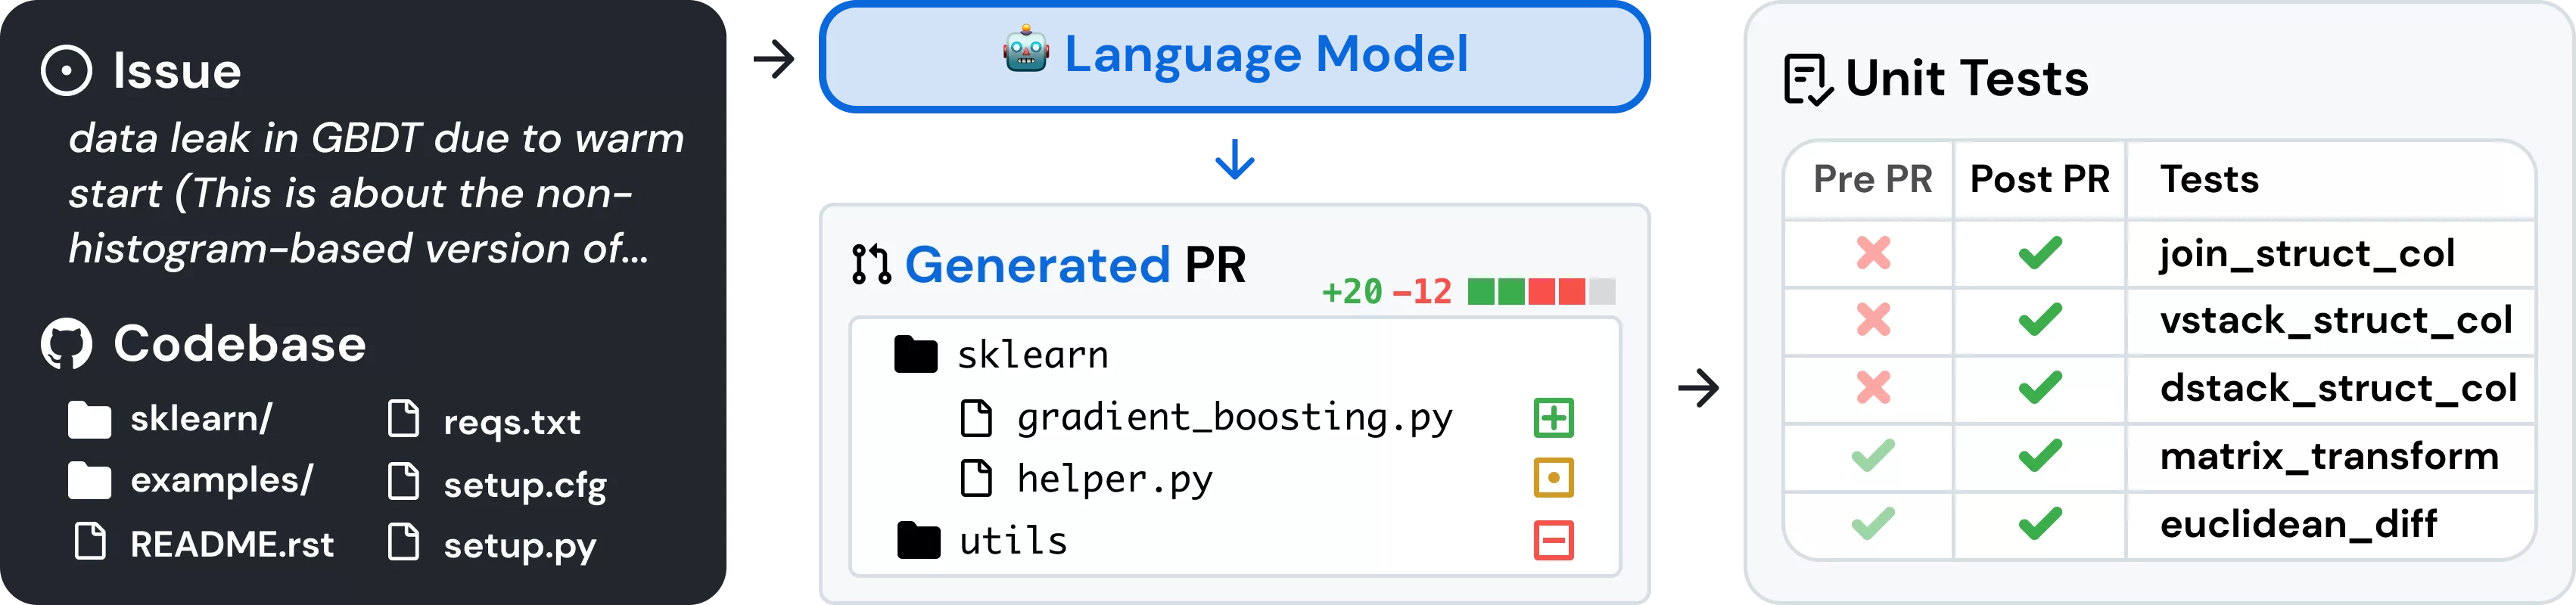
SWE-bench 与其他代码基准最大的差别在题目来源:它不是让人现场写算法题,而是把开源仓库里真实出现过的议题与对应的合并请求变成任务,模型必须给出能通过项目测试的补丁,最终指标就是「解决率」这一百分比。这样做的意义在于贴近工程现实——理解一个陌生仓库、定位缺陷、改动若干文件并保持其他功能不坏,这些能力是刷题式基准很难覆盖的。官方给出的最初版本包含 12 个 Python 仓库的 2,294 个任务实例。
品牌档案
官方把它定义为「真实软件工程问题的基准」:任务取自开源仓库的真实议题与合并请求,模型须产出能让测试通过的补丁;站点提供多个子集与公开榜单,并开源评测流程与配套工具。
深度介绍
SWE-bench 与其他代码基准最大的差别在题目来源:它不是让人现场写算法题,而是把开源仓库里真实出现过的议题与对应的合并请求变成任务,模型必须给出能通过项目测试的补丁,最终指标就是「解决率」这一百分比。这样做的意义在于贴近工程现实——理解一个陌生仓库、定位缺陷、改动若干文件并保持其他功能不坏,这些能力是刷题式基准很难覆盖的。官方给出的最初版本包含 12 个 Python 仓库的 2,294 个任务实例。
站点提供多个子集以适配不同预算与目标:Verified 是人工筛选后的 500 个实例,也是默认展示的主榜;Lite 是 300 个实例的精选子集,官方称其目的是降低评测成本;Multilingual 包含来自 42 个仓库、覆盖 9 种编程语言的 300 个任务;Multimodal 的 480 个实例其议题带有视觉元素;此外还有 500 个实例的 Bash Only 视图与完整的 2,294 实例榜。选型时先确定要回答什么问题,再决定用哪个子集,否则很容易在口径不同的分数之间做无效比较。
榜单的默认 Verified 视图提供了一个「Bash Only」模式,官方说明其中每个模型都运行在同一个轻量智能体环境里。这一点很关键:代码任务的成绩高度依赖外围脚手架(提示词、工具集、重试策略),如果不统一环境,比较的其实是「模型加框架」的组合而不是模型本身。榜单同时用标记区分开源权重模型与由 SWE-bench 团队亲自运行或核验过的条目,引用分数时值得留意这些标记。
官方榜单提供一组横向比较视图,包括按仓库与按语言的解决率分布、解决率与成本的散点图、解决率与模型发布时间的关系、以及在成本上限或步数上限约束下的表现,另有累计成本与累计步数分布。对要做采购决策的团队,这些视图比单一分数更有用——同一个解决率下,成本差几倍、或需要更多轮工具调用,工程上的意义完全不同。结果还可以导出 JSON 或 PNG,便于放进报告。
围绕基准,团队维护了一条工具链:SWE-agent 是早期的开源智能体实现,官方回顾其首版在 SWE-bench 上达到 12.47% 的解决率;mini-SWE-agent 用约 100 行 Python 实现了简化版本,官方称其在 Verified 上达到 65%;SWE-ReX 负责在沙箱中远程执行命令;SWE-smith 用于自动合成软件工程训练数据;此外还有命令行工具与两个更新的评测项目 CodeClash 与 ProgramBench。对自研智能体的团队,这套工具既是基线也是可直接复用的组件。
官方新闻页按时间列出了演进:2024 年 3 月发布 SWE-agent 与 Lite 子集,6 月把评测 Docker 化以便复现,8 月推出人工筛选的 Verified,10 月加入多模态任务;2025 年 3 月 SWE-agent 1.0 成为 Lite 榜上的开源最优,5 月发布训练数据工具 SWE-smith,7 月 mini-SWE-agent 用极简实现取得 65%;2025 年 11 月与 2026 年 5 月又分别推出面向目标导向开发的 CodeClash 与从零构建软件产物的 ProgramBench。这条时间线也说明榜单分数会随任务与环境的调整而变化。
站点提供论文、文档、博客、引用信息与新闻资料入口,并设有结果提交通道,方便模型或智能体作者把成绩加入榜单。评测代码在 GitHub 以 MIT 许可开源,仓库核验时约有 5,887 个 star,主分支在 2026 年 9 月 18 日仍有提交。做学术引用或对外发布成绩时,建议同时记录所用的子集、视图(例如是否 Bash Only)、成本与步数口径以及访问时间,否则数字之间不具备可比性。
第一,不同子集与视图的分数不可直接比较——Verified 的 500 个实例与 Bash Only 的统一环境是两套口径。第二,代码基准存在被训练数据覆盖的风险:任务来自公开仓库的公开议题,模型训练语料是否包含这些内容通常难以完全确认,因此高分需要结合其他证据判断。第三,评测需要真实运行代码与测试,会产生模型调用与算力开销,Multilingual 与 Multimodal 的开销更高;官方为此提供 Lite 等成本更低的子集,适合先做一轮筛选。
产品特点
任务由开源项目的真实议题与合并请求构成,模型必须给出能让项目测试通过的补丁,以解决率作为统一指标,比刷题式基准更接近实际工程能力。
Verified(500)、Lite(300,降低成本)、Multilingual(300,42 个仓库、9 种语言)、Multimodal(480,含视觉元素)与完整版(2,294)并存,可按预算与目标选择。
Bash Only 视图让所有模型跑在同一轻量智能体环境中,榜单还提供解决率与成本、发布时间、成本上限、步数上限等对比视图,并支持导出数据。
评测代码以 MIT 许可开源,并附 SWE-agent、mini-SWE-agent、SWE-ReX、SWE-smith 等实现与数据合成工具,便于复现结果或搭建自研评测流程。
最近动态
官方新闻显示 2026 年 5 月发布 ProgramBench,用于评测模型能否从零编写有意义的软件产物。它与既有的缺陷修复类基准互补:一个考察「改对已有代码」,一个考察「从头造出东西」。
官方新闻显示 2025 年 11 月推出 CodeClash,官方描述为把语言模型当作「目标导向而非任务导向的开发者」来评测的新基准,用于观察模型在长期目标下的开发行为。
官方新闻显示 2025 年 7 月发布的 mini-SWE-agent 用约 100 行 Python 实现了智能体流程,官方称其在 SWE-bench Verified 上达到 65% 的解决率,常被用作对照实现与教学示例。
官方新闻显示 2025 年 5 月发布 SWE-smith,用于为软件工程智能体自动合成训练数据,让团队可以训练自己的模型或智能体,而不必只依赖现成数据集;此前 2025 年 3 月 SWE-agent 1.0 曾成为 Lite 榜上的开源最优实现。
SWE-bench 是一个面向代码能力的基准,官方把它定义为「真实软件工程问题的基准」。与其他代码评测不同,它的题目来自开源仓库里真实出现过的议题与对应合并请求,模型必须给出能通过项目测试的补丁,最终以解决率这一百分比作为统一指标。最初版本包含 12 个 Python 仓库的 2,294 个任务实例,这种构造方式让它更接近真实工程:理解陌生仓库、定位缺陷、跨文件改动且不破坏既有功能。 站点围绕这一思路扩展出多个子集:人工筛选的 Verified 有 500 个实例并作为默认主榜,Lite 用 300 个实例降低评测成本,Multilingual 包含来自 42 个仓库、覆盖 9 种编程语言的 300 个任务,Multimodal 的 480 个实例其议题带有视觉元素,此外还有 500 个实例的 Bash Only 视图与完整的 2,294 实例榜。其中 Bash Only 让所有模型跑在同一个轻量智能体环境中,尽量抹平脚手架差异;榜单还提供按仓库与语言的分布、解决率与成本的散点图、与发布时间的关系、成本上限与步数上限约束下的表现等对比视图,并支持导出 JSON 或 PNG 与复制链接。 围绕基准,团队维护了一条工具链:SWE-agent 是早期开源智能体实现(首版解决率 12.47%),mini-SWE-agent 以约 100 行 Python 达到官方所称的 Verified 65%,SWE-ReX 负责沙箱内远程执行,SWE-smith 用于合成软件工程训练数据,另有命令行工具以及后续的 CodeClash(2025 年 11 月,目标导向开发评测)与 ProgramBench(2026 年 5 月,从零构建软件产物)。评测代码以 MIT 许可开源,仓库核验时约有 5,887 个 star,主分支在 2026 年 9 月 18 日仍有提交。 使用前建议注意三点:不同子集与视图的分数不可直接比较,引用时应同时记录子集、是否统一环境、成本与步数口径以及访问时间;任务来自公开仓库的公开议题,训练语料是否覆盖难以完全确认,因此高分需要结合其他证据判断;评测需要真实运行代码与测试,会产生模型调用与算力开销,官方为此提供 Lite 等更低成本的子集,适合先做一轮筛选。
核验信息
本页事实来自 SWE-bench 官方渠道:站点首页(各子集的实例数、仓库与语言覆盖、Bash Only 视图说明、对比视图类型与导出方式)、官方新闻列表(ProgramBench 2026 年 5 月、CodeClash 2025 年 11 月、mini-SWE-agent 2025 年 7 月、SWE-smith 2025 年 5 月、SWE-agent 1.0 2025 年 3 月、Multimodal 2024 年 10 月、Verified 2024 年 8 月、Docker 化 2024 年 6 月、SWE-agent 与 Lite 2024 年 3 月)、各子集榜单页面、官方仓库(许可、star 与提交时间)与官方论文链接。为遵守内容规则,致谢与新闻中涉及的受限品牌名称未在本页列出。信息核验于 2026 年 9 月 22 日,请以官方当期页面为准。
SWE-bench介绍页面对您是否有帮助?